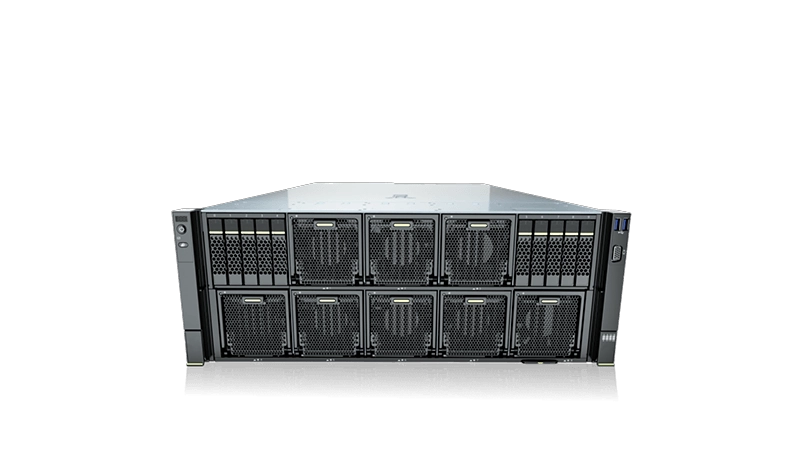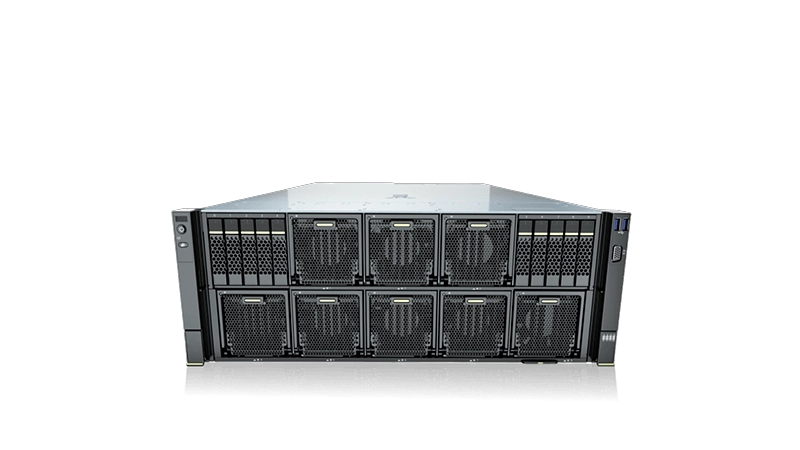
Atlas 800I A2 4U AI 推論サーバー
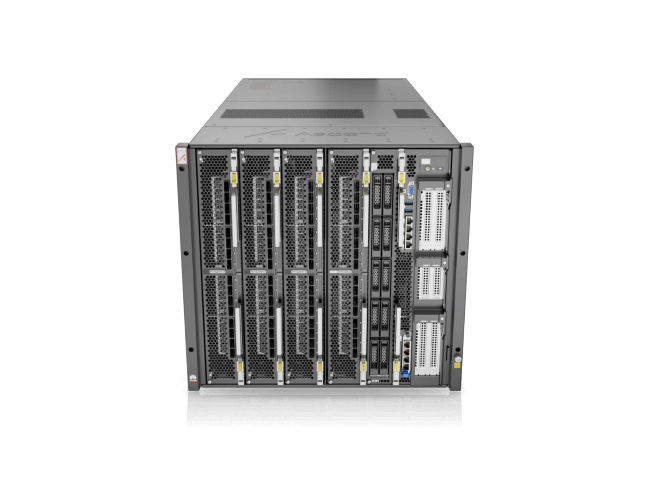
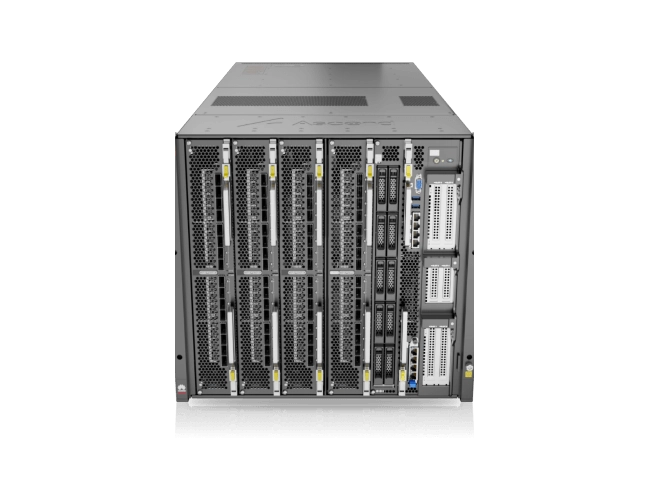
Atlas 800I A2 推論サーバーは、効率的な 8 モジュール推論アプローチを採用し、強力な AI 推論機能を提供します。コンピューティング能力、メモリ帯域幅、接続性に利点があり、インテリジェントな顧客サービス、コピーライティングの生成、知識の蓄積、その他のコンテンツ生成シナリオなど、生成的な大規模モデル推論に広く適用できます。 NPU 相互接続をサポートし、大規模モデルの推論効率を向上させます。
1. 特徴
1.1 コアハードウェア構成
• プロセッサーとアクセラレーション カード:
• CPU: Kunpeng 920 プロセッサーを 4 基搭載 (48/64 コア、クロック速度 2.6/3.0 GHz をサポート)。
• NPU (AI プロセッサ): 統合された HCCS NPU モジュールを備えた Huawei Ascend 910 AI プロセッサをベースとしています。
• メモリ容量: アクセラレータあたり 64 GB、合計 512 GB のアクセラレータ メモリ (HBM タイプ)。システム メモリは、最大 32 個の DDR4 DIMM スロットをサポートします。
• 帯域幅とバス:
• アクセラレータのメモリ帯域幅: 800 GB/秒 (NPU あたり)。
• アクセラレータ インターコネクト帯域幅: 最大 392 GB/秒 (または PCIe 4.0 x16 NPU-CPU インターコネクト経由では 512 GB/秒)。
• サポートされるデータ型: FP32、FP16、および INT8。
1.2 システムと冷却
• フォームファクタと重量: 4U フルデプスラックマウントユニット。寸法: 175 × 447 × 790 mm (高さ × 幅 × 奥行き);重量:約90kg。
• 冷却設計: N+1 冗長性を備えた 8 つのホットスワップ可能なファン モジュールを備えた、前面から背面への空冷。
• 最大システム消費電力: 10.4 kW。
1.3 ソフトウェアエコシステム
• ソフトウェアスタック: Huawei CANN、MindSpore、MindIE、AscendCL、および Ascend 用の PyTorch アダプターと完全に互換性があります。 vLLM、vLLM-Ascend、MindIE Turbo などの主流の推論フレームワークをサポートします。
• 仮想化機能: Huawei vNPU コンピューティング リソースのパーティショニング、デバイス パススルー、および Ascend ソフトウェア スタックを介したコンテナ化された展開をサポートします。典型的なアプリケーションシナリオ
• エンタープライズ グレードの大規模言語モデル (LLM) 推論、生成 AI サービス、検索拡張生成 (RAG)、インテリジェントな顧客サービス、コンテンツ生成、知識処理、および高スループット AI 推論サービス。
2. 技術仕様
| 製品 | Atlas 800I A2 推論サーバー |
| 形状 | 4U AIサーバー |
| CPU | 4 * クンペン 920 |
| メモリ | 32 DDR4 メモリ スロット、最大 3200 MT/秒 、単一のメモリースティックは 16/32/64 GB の容量をサポートします。 |
| ローカルストレージ | 8 * 2.5 SATA + 2 * 2.5 NVMe 4 * 2.5 SATA+6 * 2.5 NVMe |
| RAIDのサポート | RAID 0/1/10/5/50/6/60をサポート |
| 内部ネットワーク | 合計接続帯域幅 392GB/秒のオプションの NPU 完全相互接続モデル |
| 外部ネットワーク | 8 * 200GE QSFP インターフェイス (直接出力、RoCE プロトコル付き) |
| PCIeインターフェース | 最大 3 つの PCIe 4.0 拡張スロットをサポート |
| 電源 | 4 つのホットスワップ可能な 2.6kW 電源モジュール、2+2 冗長性をサポート |
| 電源 | AC200~240V DC240V |
| 冷却方法 | 風冷 |
| ファン | 8 つのホットスワップ可能なファン モジュールと N+1 冗長性をサポート |
| 使用環境温度 | 5℃~35℃(41℉~95℉) |
| 構造寸法 | 175mm(高さ)×447mm(幅)×790mm(奥行き) |
- その他の製品