- Sfoglia le categorie
- Drone YQFH
- Drone DJI
- Altro UAV
- Carichi utili dei droni
- Robot
- Rilevatore/localizzatore di tubazioni e GPR
- Scanner laser 3D
- Dispositivi di misurazione industriale
- Serie di stazioni meteorologiche
- Strumenti di rilevamento ottici
- Sistemi GNSS RTK
- Prodotti del sistema BDS
- Sistema di monitoraggio dello spostamento visivo
- Sistema di posizionamento per interni UWB
- Prodotti per l'idrologia
- Altri
- Spettrometro
- Macchina per sabbiatura a umido
- Tester del suolo SDI
- Pengjin Smart Flying Drone Patrol e sistema di ispezione
- Supercalcolo
- Viscosimetro
- Igrotermografo elettrico
- Ecoscandaglio
- Software
- Strumenti di misurazione Keson
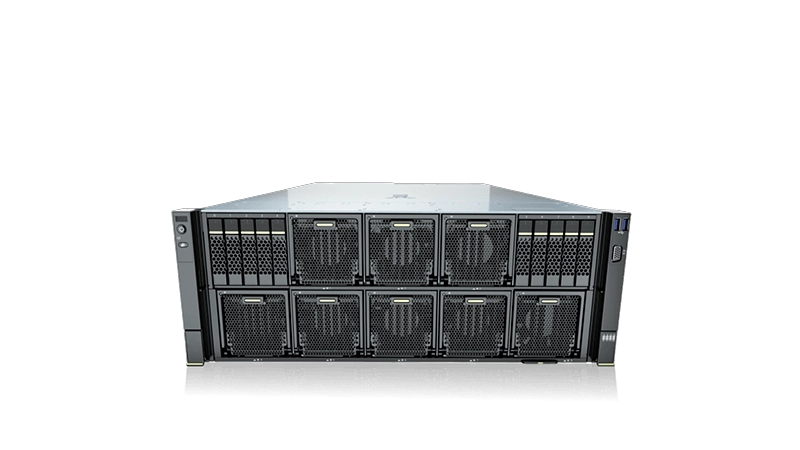
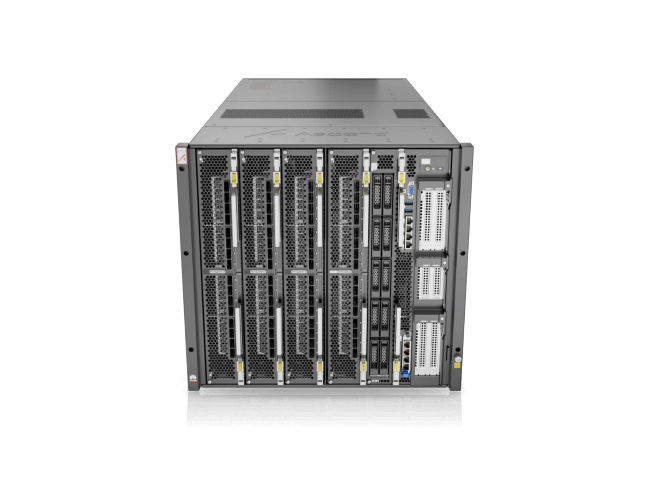
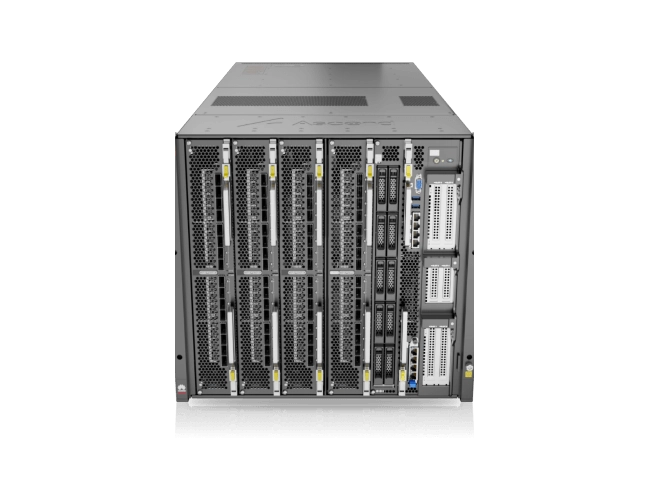
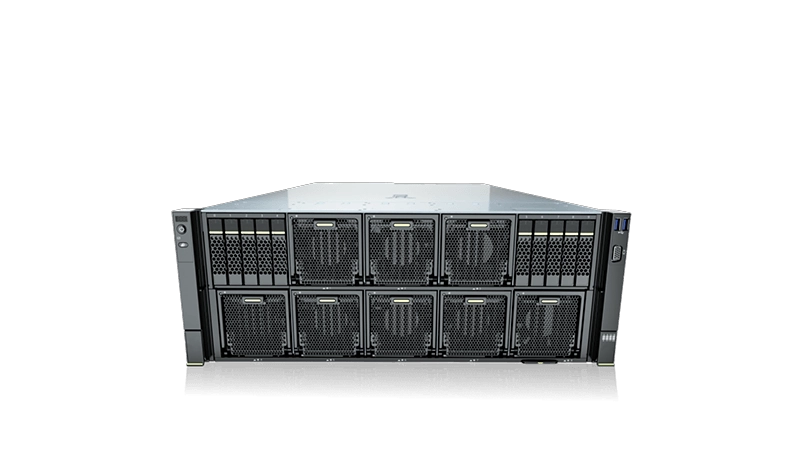
Server di inferenza AI Atlas 800I A2 4U
Il server di inferenza Atlas 800I A2 adotta un efficiente approccio di inferenza a 8 moduli, fornendo potenti capacità di inferenza AI. Presenta vantaggi in termini di potenza di calcolo, larghezza di banda della memoria e connettività e può essere ampiamente applicato all'inferenza generativa di modelli di grandi dimensioni, come il servizio clienti intelligente, la generazione di copywriting, l'accumulo di conoscenze e altri scenari di generazione di contenuti. Supporta l'interconnessione NPU per migliorare l'efficienza dell'inferenza di modelli di grandi dimensioni.
1. Caratteristiche
1.1 Configurazione hardware principale
• Processori e schede di accelerazione:
• CPU: dotato di 4 processori Kunpeng 920 (che supportano 48/64 core, con velocità di clock di 2,6/3,0 GHz).
• NPU (processore AI): basato sul processore AI Huawei Ascend 910, dotato di un modulo NPU HCCS integrato.
• Capacità di memoria: 64 GB per acceleratore, per un totale di 512 GB di memoria dell'acceleratore (tipo HBM); la memoria di sistema supporta fino a 32 slot DIMM DDR4.
• Larghezza di banda e bus:
• Larghezza di banda della memoria dell'acceleratore: 800 GB/s (per NPU).
• Larghezza di banda di interconnessione dell'acceleratore: fino a 392 GB/s (o 512 GB/s tramite interconnessione PCIe 4.0 x16 NPU-CPU).
• Tipi di dati supportati: FP32, FP16 e INT8.
1.2 Sistema e raffreddamento
• Fattore di forma e peso: unità montata su rack a profondità completa 4U; dimensioni: 175 × 447 × 790 mm (A x L x P); peso: circa 90 kg.
• Design di raffreddamento: raffreddamento ad aria dalla parte anteriore a quella posteriore, con 8 moduli ventola sostituibili a caldo con ridondanza N+1.
• Consumo energetico massimo del sistema: 10,4 kW.
1.3 Ecosistema software
• Stack software: completamente compatibile con Huawei CANN, MindSpore, MindIE, AscendCL e l'adattatore PyTorch per Ascend; supporta i principali framework di inferenza come vLLM, vLLM-Ascend e MindIE Turbo.
• Funzionalità di virtualizzazione: supporta il partizionamento delle risorse di calcolo Huawei vNPU, il passthrough dei dispositivi e l'implementazione containerizzata tramite lo stack software Ascend. Scenari applicativi tipici
• Inferenza LLM (Large Language Model) di livello aziendale, servizi di intelligenza artificiale generativa, RAG (Retrieval-Augmented Generation), servizio clienti intelligente, generazione di contenuti, elaborazione della conoscenza e servizi di inferenza di intelligenza artificiale ad alto throughput.
2. Specifiche tecniche
| Prodotti | Server di inferenza Atlas 800I A2 |
| Modulo | Server IA 4U |
| processore | 4 * Kunpeng 920 |
| Memoria | 32 slot di memoria DDR4, fino a 3200 MT/s e la memory stick singola supporta una capacità di 16/32/64 GB |
| Archiviazione locale | 8*2.5 SATA+2*2.5 NVMe 4*2.5 SATA+6*2.5 NVMe |
| Supporto RAID | Supporta RAID 0/1/10/5/50/6/60 |
| Rete interna | Un modello NPU opzionale completamente interconnesso con una larghezza di banda di connettività totale di 392 GB/s |
| Reti esterne | Interfacce QSFP 8 * 200GE con uscita diretta, protocollo RoCE |
| Interfaccia PCIe | Supporta fino a 3 slot di espansione PCIe 4.0 |
| Alimentazione elettrica | Quattro moduli di potenza da 2,6 kW sostituibili a caldo, che supportano la ridondanza 2+2 |
| Alimentazione elettrica | 200 ~ 240 V CA 240 V CC |
| Metodo di raffreddamento | Raffreddamento dal vento |
| Fan | Supporta 8 moduli ventola sostituibili a caldo e ridondanza N+1 |
| Temperatura dell'ambiente operativo | 5℃~35℃(41℉~95℉) |
| Dimensioni strutturali | 175 mm (altezza) * 447 mm (larghezza) * 790 mm (profondità) |