- Sfoglia le categorie
- Drone YQFH
- Drone DJI
- Altro UAV
- Carichi utili dei droni
- Robot
- Rilevatore/localizzatore di tubazioni e GPR
- Scanner laser 3D
- Dispositivi di misurazione industriale
- Serie di stazioni meteorologiche
- Strumenti di rilevamento ottici
- Sistemi GNSS RTK
- Prodotti del sistema BDS
- Sistema di monitoraggio dello spostamento visivo
- Sistema di posizionamento per interni UWB
- Prodotti per l'idrologia
- Altri
- Spettrometro
- Macchina per sabbiatura a umido
- Tester del suolo SDI
- Pengjin Smart Flying Drone Patrol e sistema di ispezione
- Supercalcolo
- Viscosimetro
- Igrotermografo elettrico
- Ecoscandaglio
- Software
- Strumenti di misurazione Keson
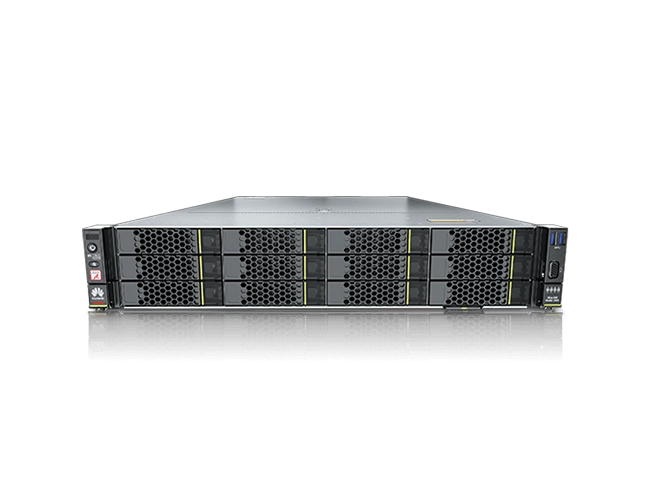
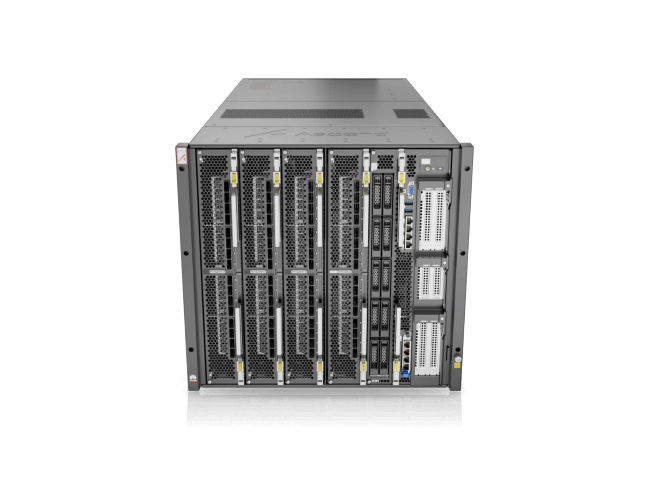
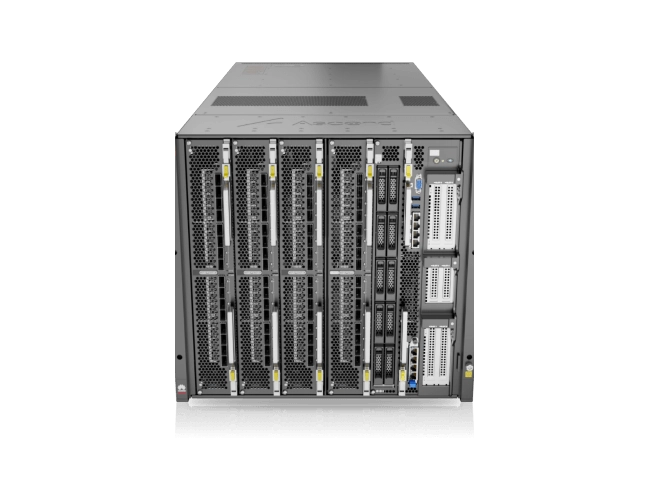
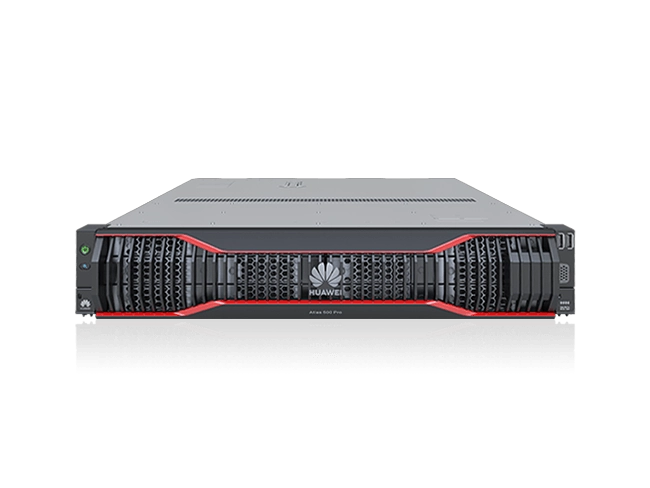
Server di inferenza Atlas 800 per la formazione sull'intelligenza artificiale (modello: 3000)
Il server di inferenza Atlas 800 (modello: 3000) supporta fino a 8 Atlas 300I/V Pro, fornendo potenti funzionalità di inferenza e analisi video in tempo reale, ampiamente utilizzate negli scenari di inferenza AI lato centrale.
1. Modelli chiave e caratteristiche principali
1.1 Server di inferenza Atlas 800 (ad esempio, modello 3000 / Atlas 800I A2 / Atlas 800I A3)
- Processori core: alimentati da processori Huawei Kunpeng 920 o processori AI della serie Ascend (come Ascend 910C).
- Funzioni primarie: incentrato su inferenza in tempo reale, servizi di intelligenza artificiale generativa, inferenza LLM (Large Language Model), servizio clienti intelligente e analisi di video/immagini.
- Prestazioni e configurazione: supporta memoria con accelerazione a larghezza di banda elevata ed elaborazione dati video/AI multicanale; è dotato di un efficiente raffreddamento ad aria e di alimentatori ridondanti sostituibili a caldo.
1.2 Server di formazione Atlas 800 (ad esempio, modello 9000/modello 9010)
- Processori core: basati sui processori AI Kunpeng 920 e Ascend 910 (o configurati con processori Intel).
- Funzioni primarie: progettate specificamente per lo sviluppo di modelli di deep learning e scenari di formazione AI su larga scala.
- Caratteristiche principali: offre elevata densità di elaborazione, efficienza energetica superiore, elevata larghezza di banda di rete e un'architettura con montaggio su rack 4U facile da scalare e gestire.
1.3 Ecosistema software
- Fornisce supporto completo per l'architettura hardware e software IA full-stack di Huawei, inclusi CANN, MindSpore, MindIE e AscendCL, garantendo al tempo stesso la compatibilità con framework tradizionali come PyTorch.
2. Specifiche tecniche
| Prodotti | Server di inferenza Atlas 800 (modello: 3000) |
| processore | Kunpeng920*2 |
| Memoria della CPU | 32 slot di memoria DDR4, fino a 3200 MT/s |
| Scheda acceleratore AI | Supporta fino a 8 chip Atlas 300I/V Pro |
| Potenza di calcolo dell’intelligenza artificiale | Fino a 1120 TOP INT8 |
| Archiviazione locale | 3.5SAS/SATA*12 2,5SAS/SATA*25 2.5SAS/SATA*24 2.5SAS/SATA*8 |
| Archiviazione locale | 25*2.5SAS/SATA 12*3.5SAS/SATA 8*2,5 SAS/SATA+12x2,5 NVMe |
| Supporto RAID | RAID 0/1/10/5/50/6/60, ecc |
| PCle | Supporta fino a 9 interfacce PCIe 4.0, incluso 1 slot di espansione PCIe dedicato per schede SIM RAID e 8 slot di espansione PCIe standard |
| Alimentazione elettrica | Due 900 W o 2000 W sostituibili a caldo Moduli di alimentazione CA supporta il backup ridondante 1+1 |
| Fan | Quattro ventole sostituibili a caldo che supportano il backup ridondante N+1 |
| Temperatura dell'ambiente operativo | 5℃ ~ 40℃ (41°F ~ 104°F) |
| Modulo | Server IA 2U |
| Dimensioni strutturali | 447 mm * 790 mm * 86,1 mm |
Etichetta: