- Sfoglia le categorie
- Drone YQFH
- Drone DJI
- Altro UAV
- Carichi utili dei droni
- Robot
- Rilevatore/localizzatore di tubazioni e GPR
- Scanner laser 3D
- Dispositivi di misurazione industriale
- Serie di stazioni meteorologiche
- Strumenti di rilevamento ottici
- Sistemi GNSS RTK
- Prodotti del sistema BDS
- Sistema di monitoraggio dello spostamento visivo
- Sistema di posizionamento per interni UWB
- Prodotti per l'idrologia
- Altri
- Spettrometro
- Macchina per sabbiatura a umido
- Tester del suolo SDI
- Pengjin Smart Flying Drone Patrol e sistema di ispezione
- Supercalcolo
- Viscosimetro
- Igrotermografo elettrico
- Ecoscandaglio
- Software
- Strumenti di misurazione Keson
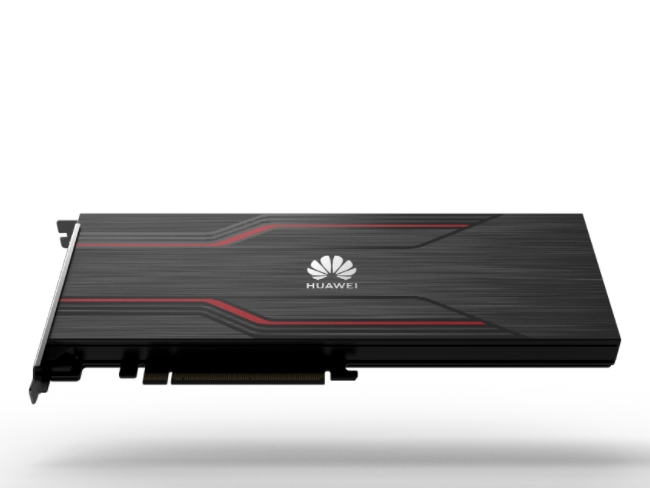
Scheda di ragionamento Huawei Atlas 300I Duo Acceleratore di inferenza AI a doppio chip
La scheda di inferenza Atlas 300I Duo integra "processore generico, AI Core e codec" in uno, offrendo inferenza Al, analisi video e altre funzioni. Vanta una potente potenza di calcolo, un'efficienza energetica elevatissima e un'analisi video ad alte prestazioni, che lo rendono ampiamente applicabile in scenari come Internet, città intelligenti e trasporti intelligenti. Supporta molteplici applicazioni tra cui clustering di ricerca, moderazione dei contenuti, riconoscimento OCR, analisi vocale e analisi video.
1. Specifiche chiave
- Processori: 2 processori AI Ascend 310P (16 core AI Da Vinci e 16 core CPU Huawei per chip).
- Potenza di calcolo: 280 TOPS INT8 e 140 TFLOPS FP16 (combinati su entrambi i chip; 140 TOPS e 70 TFLOPS per chip).
- Memoria: LPDDR4X da 48 GB o 96 GB con ECC, che fornisce una larghezza di banda combinata totale di 408 GB/s (circa 204 GB/s per chip poiché la memoria non è in pool).
- Fattore di forma e potenza: scheda PCIe Gen 4 x16 a slot singolo con design di raffreddamento passivo da 150 W.
- Media Engine: decodifica hardware integrata per 256 canali di 1080p30 o 32 canali di 4K60.
2. Limitazioni delle prestazioni e dell'ecosistema
- Stack software: si basa sull'architettura CANN proprietaria di Huawei anziché su CUDA. Gli strumenti tradizionali come Ollama o i flussi di lavoro GGUF standard devono affrontare una forte instabilità, richiedendo backend o soluzioni alternative specifiche (come GPUStack o build personalizzate di llama.cpp).
- Compatibilità hardware: la maggior parte delle schede madri desktop standard e dei sistemi consumer non possono facilmente avviare o alimentare correttamente la scheda; è ufficialmente progettato e convalidato per server aziendali specifici come Huawei Atlas 800.
- Consenso della community: la maggior parte degli utenti sui forum TechPowerUp e r/LocalLLaMA concordano sul fatto che, sebbene il rapporto prezzo/VRAM non abbia eguali per la sperimentazione LLM (Local Large Language Model), i mal di testa dei driver, la mancanza di supporto plug-and-play e i vincoli di memoria split-chip ne fanno una scheda di progetto piuttosto che un sostituto immediato per l'hardware NVIDIA.
3. Specifiche tecniche
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Etichetta: