- Parcourir les catégories
- Drone YQFH
- Drone DJI
- Autre drone
- Charges utiles des drones
- Robot
- Détecteur de pipeline/ localisateur et GPR
- Scanner laser 3D
- Appareils de mesure industriels
- Série de stations météorologiques
- Instruments d'arpentage optique
- Systèmes GNSS RTK
- Produits du système BDS
- Système de surveillance visuelle des déplacements
- Système de positionnement intérieur UWB
- Produits d'hydrologie
- Autres
- Spectromètre
- Machine de sablage humide
- Testeur de sol SDI
- Système de patrouille et d'inspection de drones volants intelligents Pengjin
- Supercalcul
- Viscosimètre
- Hygro-thermographe électrique
- Échosondeur
- Logiciel
- Outils de mesure Keson
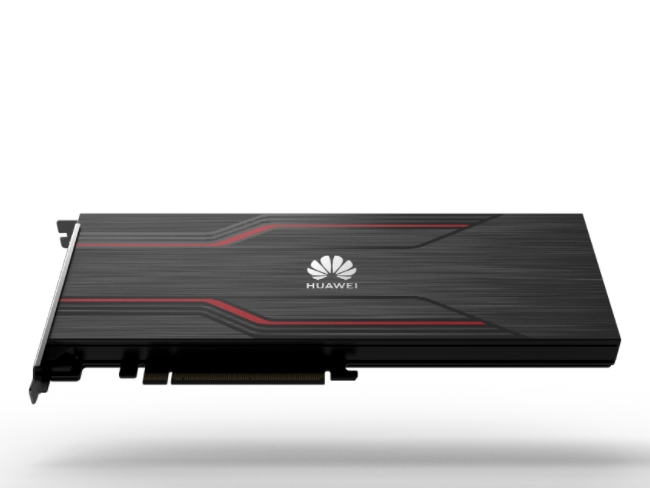
Carte de raisonnement Huawei Atlas 300I Duo, accélérateur d'inférence AI à double puce
La carte d'inférence Atlas 300I Duo intègre « un processeur à usage général, un cœur AI et un codec » en un seul, offrant l'inférence Al, l'analyse vidéo et d'autres fonctions. Il dispose d'une puissance de calcul puissante, d'une efficacité énergétique ultra-élevée et d'une analyse vidéo haute performance, ce qui le rend largement applicable dans des scénarios tels qu'Internet, les villes intelligentes et les transports intelligents. Il prend en charge plusieurs applications, notamment le regroupement de recherche, la modération de contenu, la reconnaissance OCR, l'analyse vocale et l'analyse vidéo.
1. Spécifications clés
- Processeurs : 2 x processeurs Ascend 310P AI (16 cœurs Da Vinci AI et 16 cœurs CPU Huawei par puce).
- Puissance de calcul : 280 TOPS INT8 et 140 TFLOPS FP16 (combinés sur les deux puces ; 140 TOPS et 70 TFLOPS par puce).
- Mémoire : 48 Go ou 96 Go LPDDR4X avec ECC, offrant une bande passante totale combinée de 408 Go/s (environ 204 Go/s par puce car la mémoire n'est pas mise en pool).
- Facteur de forme et puissance : carte PCIe Gen 4 x16 à emplacement unique avec une conception de refroidissement passif de 150 W.
- Moteur multimédia : décodage matériel intégré pour 256 chaînes de 1080p30 ou 32 chaînes de 4K60.
2. Performances et limites de l'écosystème
- Pile logicielle : elle s'appuie sur l'architecture CANN propriétaire de Huawei plutôt que sur CUDA. Les outils grand public comme Ollama ou les workflows GGUF standard sont confrontés à une forte instabilité, nécessitant des backends ou des solutions de contournement spécifiques (telles que GPUStack ou des versions personnalisées de llama.cpp).
- Compatibilité matérielle : la plupart des cartes mères de bureau standard et des systèmes grand public ne peuvent pas facilement démarrer ou alimenter la carte correctement ; il est officiellement conçu et validé pour des serveurs d'entreprise spécifiques comme le Huawei Atlas 800.
- Consensus de la communauté : la plupart des utilisateurs des forums TechPowerUp et de r/LocalLLaMA conviennent que même si le rapport prix/VRAM est inégalé pour l'expérimentation de modèles de langage étendus locaux (LLM), les problèmes de pilote, le manque de prise en charge plug-and-play et les contraintes de mémoire sur puce divisée en font une carte de projet plutôt qu'un remplacement immédiat du matériel NVIDIA.
3. Spécifications techniques
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Étiqueter:
Shenzhen Peng Jin Technology Co., Ltd.
Tél:+8615899753550
Wechat:pjk2018666
Personne de contact:Linda Lin
- Autres produits